Agent = Model + Harness, vậy tại sao ai cũng PR Model?
Model luôn đứng trên sân khấu cùng benchmark. Nhưng dùng agent một thời gian, tôi lại thấy harness mới là thứ quyết định khá nhiều trải nghiệm thực tế. Vậy các hãng AI có bỏ quên nó không?
Mấy ông lớn ra model mới là lại benchmark.
GPT mới — benchmark. Claude mới — benchmark. Gemini mới — cũng benchmark.
Coding tốt hơn bao nhiêu %, reasoning đứng đâu, nhanh hơn, rẻ hơn… nhìn một hồi cảm giác cuộc đua AI gần như là cuộc đua model.
Nhưng dùng mấy coding agent một thời gian thì tôi lại thấy có gì đó không ổn lắm.
Agent = Model + Harness
Cùng một model, đặt vào hai agent khác nhau có khi trải nghiệm khác hẳn. Thằng tìm file tốt hơn, thằng giữ context lâu hơn, thằng biết chạy test rồi tự sửa, thằng thì sửa xong báo “done” rất tự tin :v
Vậy tại sao lúc ra mắt sản phẩm, model vẫn luôn đứng trên sân khấu còn harness gần như ở sau cánh gà?
Tôi tò mò nên đi đào thử.
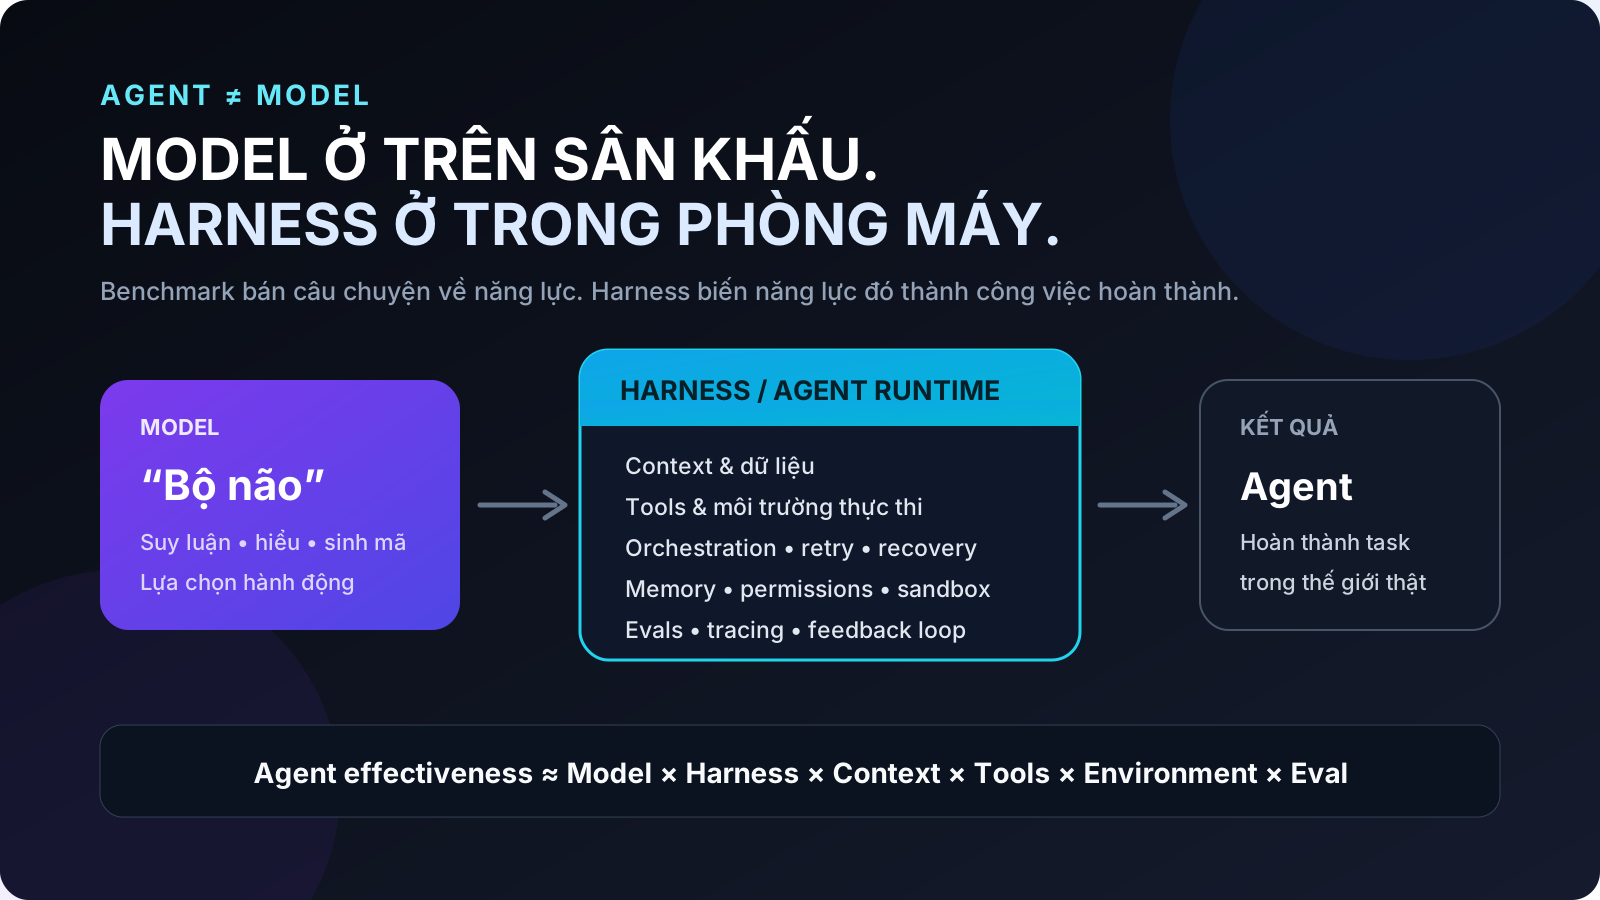
Model mạnh chưa chắc agent ngon
Nói Agent = Model + Harness thực ra vẫn hơi đơn giản.
Nếu phải hình dung, tôi thấy nó gần kiểu này hơn:
Model
  + context
  + tools
  + permissions
  + sandbox
  + retry
  + memory
  + eval
  + một đống glue code
  = thứ mà user gọi là Agent
Model có thể rất thông minh. Nhưng nếu agent tìm sai file, context đầy rác, gọi tool sai, không biết retry hoặc sửa code xong không chạy test thì cuối cùng vẫn dở.
Ngược lại, cùng model đó nhưng harness làm tốt mấy việc nhỏ nhỏ phía trên thì cảm giác lại khác hẳn.
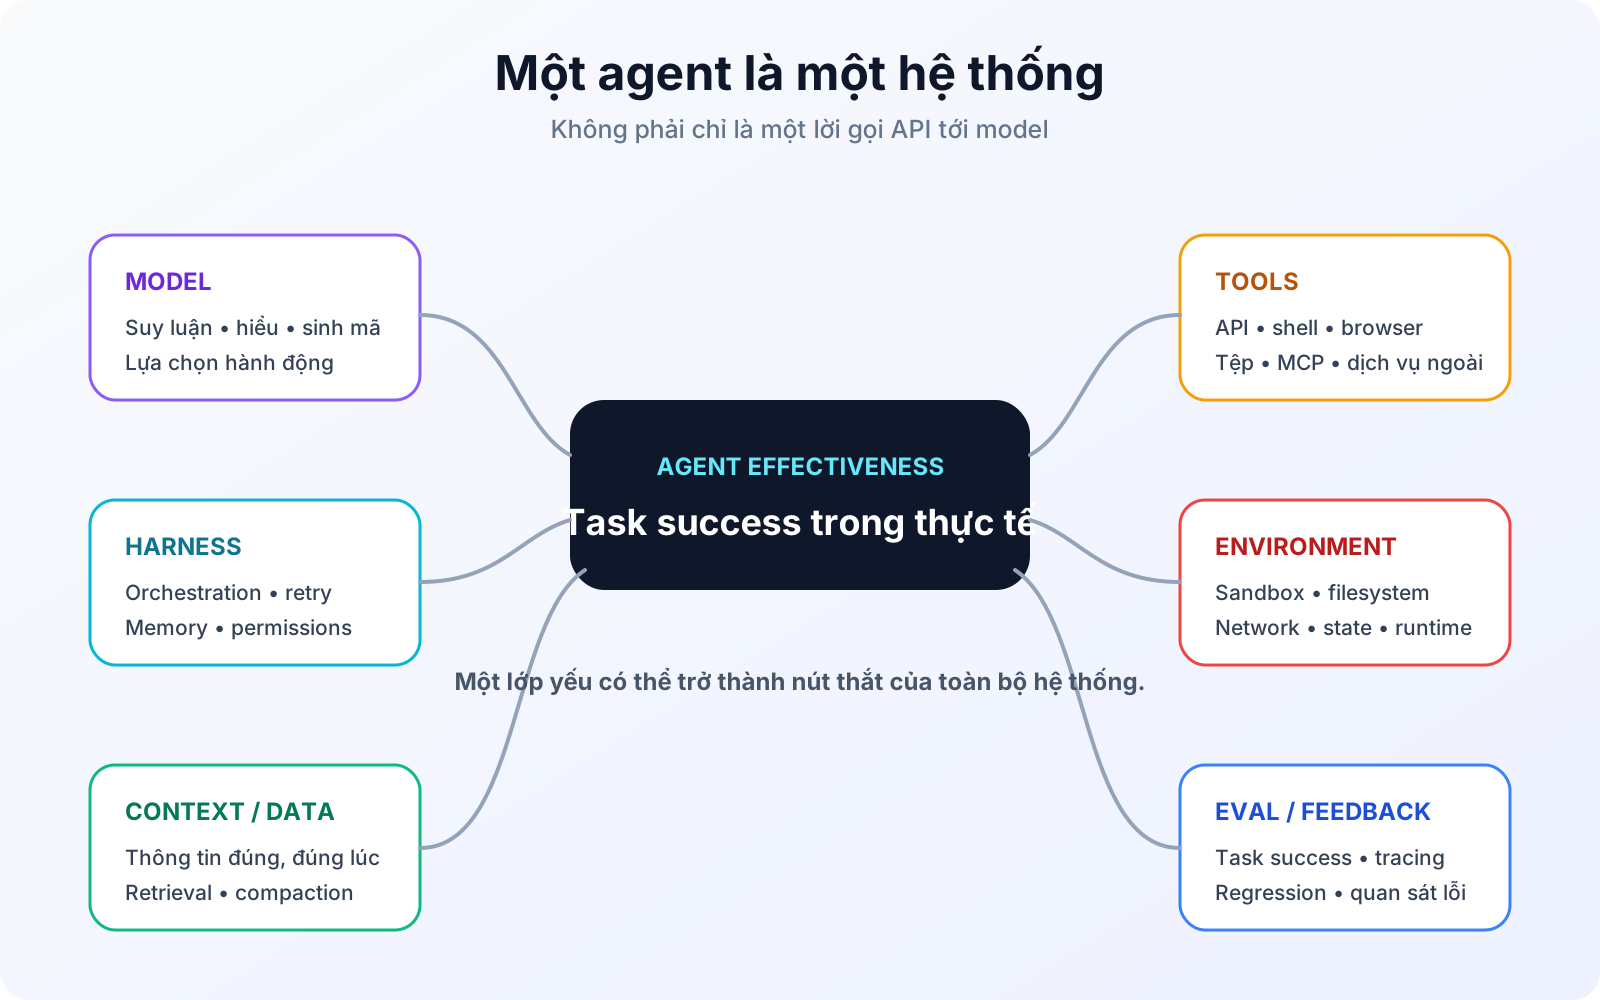
OpenAI trong A practical guide to building agents cũng tách model, tools và instructions thành các thành phần khác nhau. Anthropic khi nói về eval agent thì còn ghi khá rõ: thứ được đánh giá thực tế là harness và model chạy cùng nhau.
Vậy các hãng chắc chắn biết chuyện này.
Câu hỏi còn lại là: biết rồi, sao vẫn PR model nhiều thế?
Vì model dễ bán hơn
Đây có lẽ là lý do đơn giản nhất.
Một câu như:
Model X tăng 12 điểm trên benchmark Y.
rất dễ đưa lên slide.
Còn:
Chúng tôi cải thiện context compaction, tool routing, retry policy, filesystem abstraction, checkpoint và permission boundary.
… nghe đúng chất changelog cho developer hơn là keynote =))
Benchmark biến một thứ khá mơ hồ như “model thông minh hơn” thành con số có thể đặt cạnh đối thủ. Người đọc không cần hiểu hệ thống bên dưới vẫn thấy được: cột này cao hơn cột kia.
Model cũng gắn trực tiếp với thứ các provider bán:
Product / Developer
       ↓
Agent / Harness
       ↓
Model API
       ↓
Tokens + inference + compute
Model flagship mạnh hơn → có lý do nâng cấp subscription, thử API mới, chuyển workload sang model mới.
Nên PR model cũng chính là PR cho thứ dễ định giá nhất trong business của họ.
Còn một chuyện nữa: model tạo cảm giác về moat tốt hơn.
Để train frontier model cần compute, data, research, post-training và rất nhiều tiền. Trong khi một ý tưởng harness hay như subagent, memory, skill, checkpoint hay planner/evaluator loop có thể lan rất nhanh sang sản phẩm khác.
Không có nghĩa harness dễ làm. Làm cho nó chạy ngon ở production chắc chắn không dễ. Nhưng kể câu chuyện “model của tôi thông minh hơn” vẫn sexy hơn “retry loop của tôi ngon hơn”.
Nhưng họ có bỏ quên harness không?
Không.
Đây là chỗ tôi thấy thú vị nhất sau khi đào tài liệu của ba ông lớn.
OpenAI có Agents SDK, Codex agent loop, computer environment và thậm chí dùng cụm model-native harness khi nói về Agents SDK mới.
Anthropic thì Claude Code gần như là demo sống cho chuyện harness quan trọng thế nào: permissions, hooks, subagents, background tasks, checkpoints, context management… Họ còn có riêng các bài nghiên cứu về harness cho long-running agents.
Google với ADK 2.0 đi theo một hướng cũng khá hay: những thứ routing, scheduling, error handling hay workflow bắt buộc thì trả lại cho code deterministic; chỉ giao cho LLM những node thật sự cần reasoning.
Tức là:
Không phải model mạnh hơn thì cứ quăng thêm việc cho model là agent sẽ tốt hơn.
Đôi khi harness tốt vì nó biết việc nào không nên cho model làm.
Benchmark cũng hơi lươn
Không phải benchmark sai. Nhưng nhìn một con số rồi kết luận “model này làm agent tốt nhất” thì hơi nhanh.
Với coding agent, kết quả còn phụ thuộc vào:
- harness/scaffold nào đang chạy;
- agent được cấp tool gì;
- tìm code bằng cách nào;
- context được giữ/nén/reset ra sao;
- có retry hay verifier không;
- token/compute budget bao nhiêu;
- sandbox thế nào;
- có chạy test không.
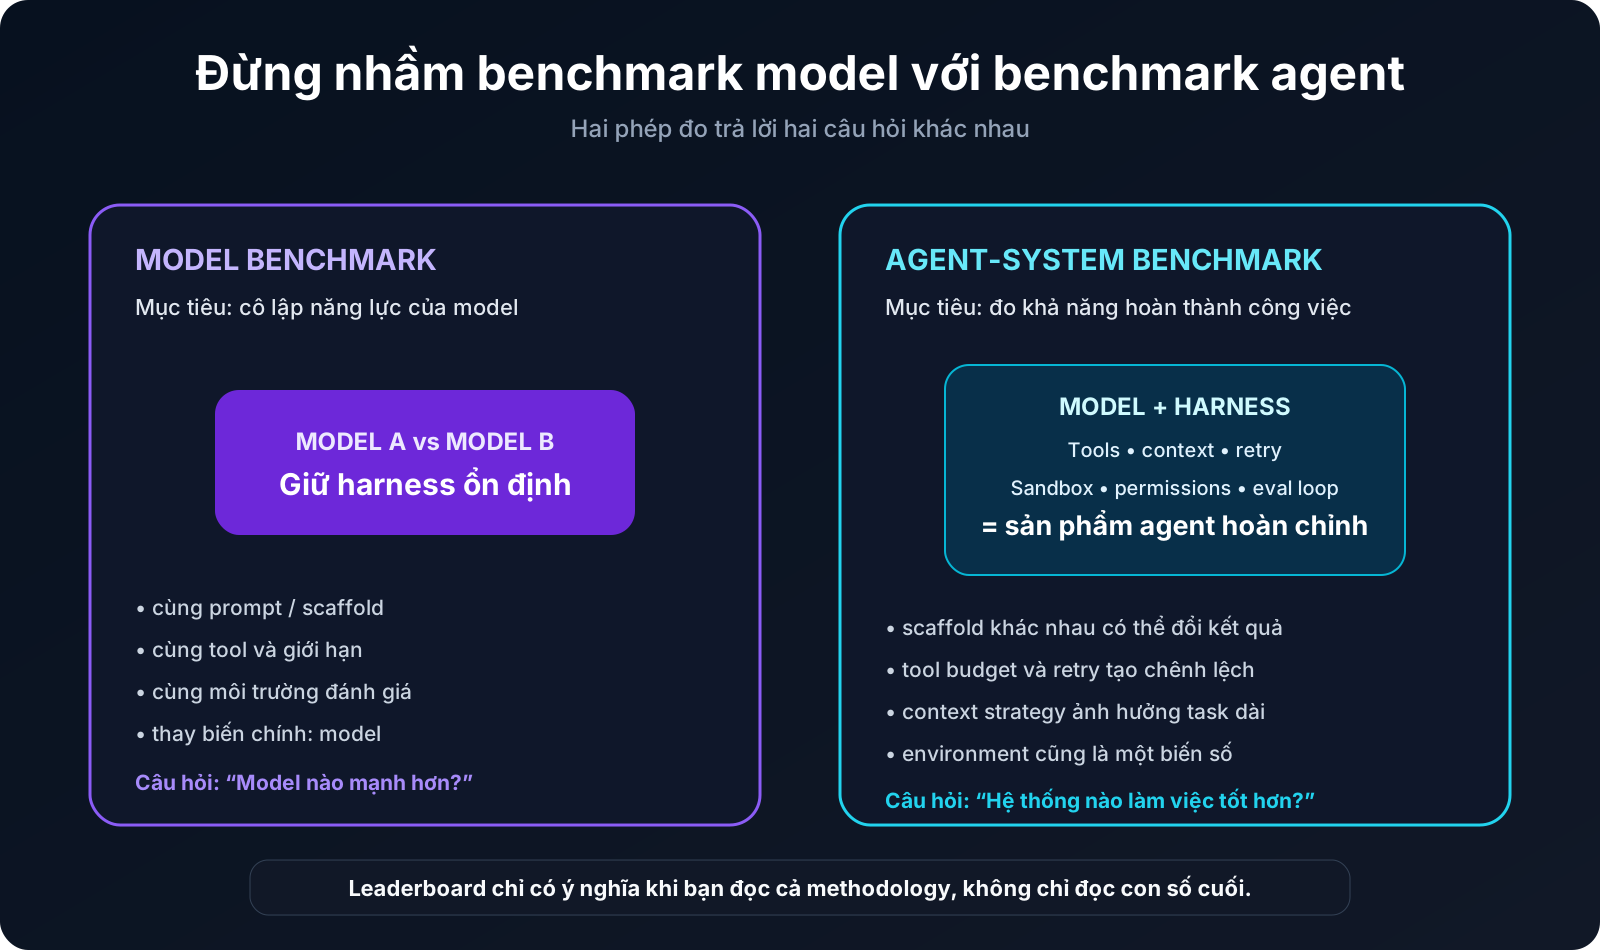
SWE-bench còn có một thứ cũng gọi là evaluation harness để dựng environment, apply patch và chạy test. Cái này lại khác với agent harness phía trên.
Một bên là máy chấm. Một bên là hệ thống giúp model làm bài.
Cùng chữ harness, khác việc. Dễ loạn thật.
Nên giờ khi nhìn benchmark agent, thay vì chỉ nhìn con số cuối tôi thường muốn biết thêm ba thứ:
- Model nào?
- Harness nào?
- Budget và environment thế nào?
Thiếu ba thứ này thì leaderboard vẫn hữu ích để tham khảo, nhưng tôi không muốn suy ra quá nhiều từ nó.
Cuối cùng vẫn là một bài toán system
Sau khi đọc một vòng, tôi thấy câu trả lời cho câu hỏi ban đầu khá đơn giản.
Các hãng không bỏ quên harness.
Model đứng trên sân khấu vì nó dễ đặt tên, dễ benchmark, dễ định giá và dễ bán. Harness thì nằm phía sau, khó gói vào một con số đẹp, nhưng lại quyết định rất nhiều thứ user thật sự cảm nhận khi dùng agent.
Và càng dùng agent để code, tôi càng thấy chọn model chỉ là bước đầu.
Với một project thật, câu hỏi hữu ích hơn có lẽ không phải:
Model nào đang top leaderboard?
Mà là:
Với repo của tôi, tool của tôi, workflow của tôi và budget của tôi, combo nào làm xong việc tốt nhất?
Nghĩ lại thì cũng hợp lý.
Model dễ đem lên sân khấu. Harness là một đống thứ nhỏ nhỏ nằm trong phòng máy: context, tool, permission, sandbox, retry, memory…
Nhưng chính đống “nhỏ nhỏ” đó lại biến một model biết trả lời thành một agent biết làm việc.
Model bán giấc mơ. Harness biến nó thành sản phẩm.
Đại khái vậy.
Tài liệu tham khảo
OpenAI
- GPT-5.6: Frontier intelligence that scales with your ambition, OpenAI, 2026.
- The next evolution of the Agents SDK, OpenAI, 2026.
- Unrolling the Codex agent loop, OpenAI, 2026.
- From model to agent: Equipping the Responses API with a computer environment, OpenAI, 2026.
- A practical guide to building agents, OpenAI.
- Separating signal from noise in coding evaluations, OpenAI, 2026.
Anthropic
- Introducing Claude Opus 5, Anthropic, 2026.
- Demystifying evals for AI agents, Anthropic, 2026.
- Effective harnesses for long-running agents, Anthropic, 2025.
- Harness design for long-running application development, Anthropic, 2026.
- Enabling Claude Code to work more autonomously, Anthropic, 2025.
- Introducing Gemini 3.8 Flash and 3.8 Flash Cyber, Google, 2026.
- Why we built ADK 2.0, Google Developers Blog, 2026.
- Agent Development Kit: Making it easy to build multi-agent applications, Google Developers Blog, 2025.
Benchmark
- SWE-bench — Evaluation Harness Reference, SWE-bench.
- SWE-bench — Overview, SWE-bench.